10分で読めます
YouTubeコメントスクレイパーは、動画のコメントを検索・分析・コード処理できるレコードとして収集します。たまにスプレッドシートが必要なだけなら、ノーコードツールが通常は最短の出発点です。カスタマイズして繰り返し実行するワークフローなら、YouTube Data APIを使うPythonでリクエストと出力を制御できます。
方法を選ぶ前に、返信を収集するか、すべての結果ページをたどるか、失敗したリクエストを報告するかを確認してください。これらの詳細が、データから何を結論づけられるかを決めます。
このガイドでは方法を比較し、トップレベルコメント用のPython例を紹介します。スプレッドシートが必要だとすでに決まっている場合は、YouTubeコメントのエクスポートチュートリアルでダウンロードとExcelの手順を確認してください。
YouTubeコメントのスクレイピング方法はどれを使うべきか?
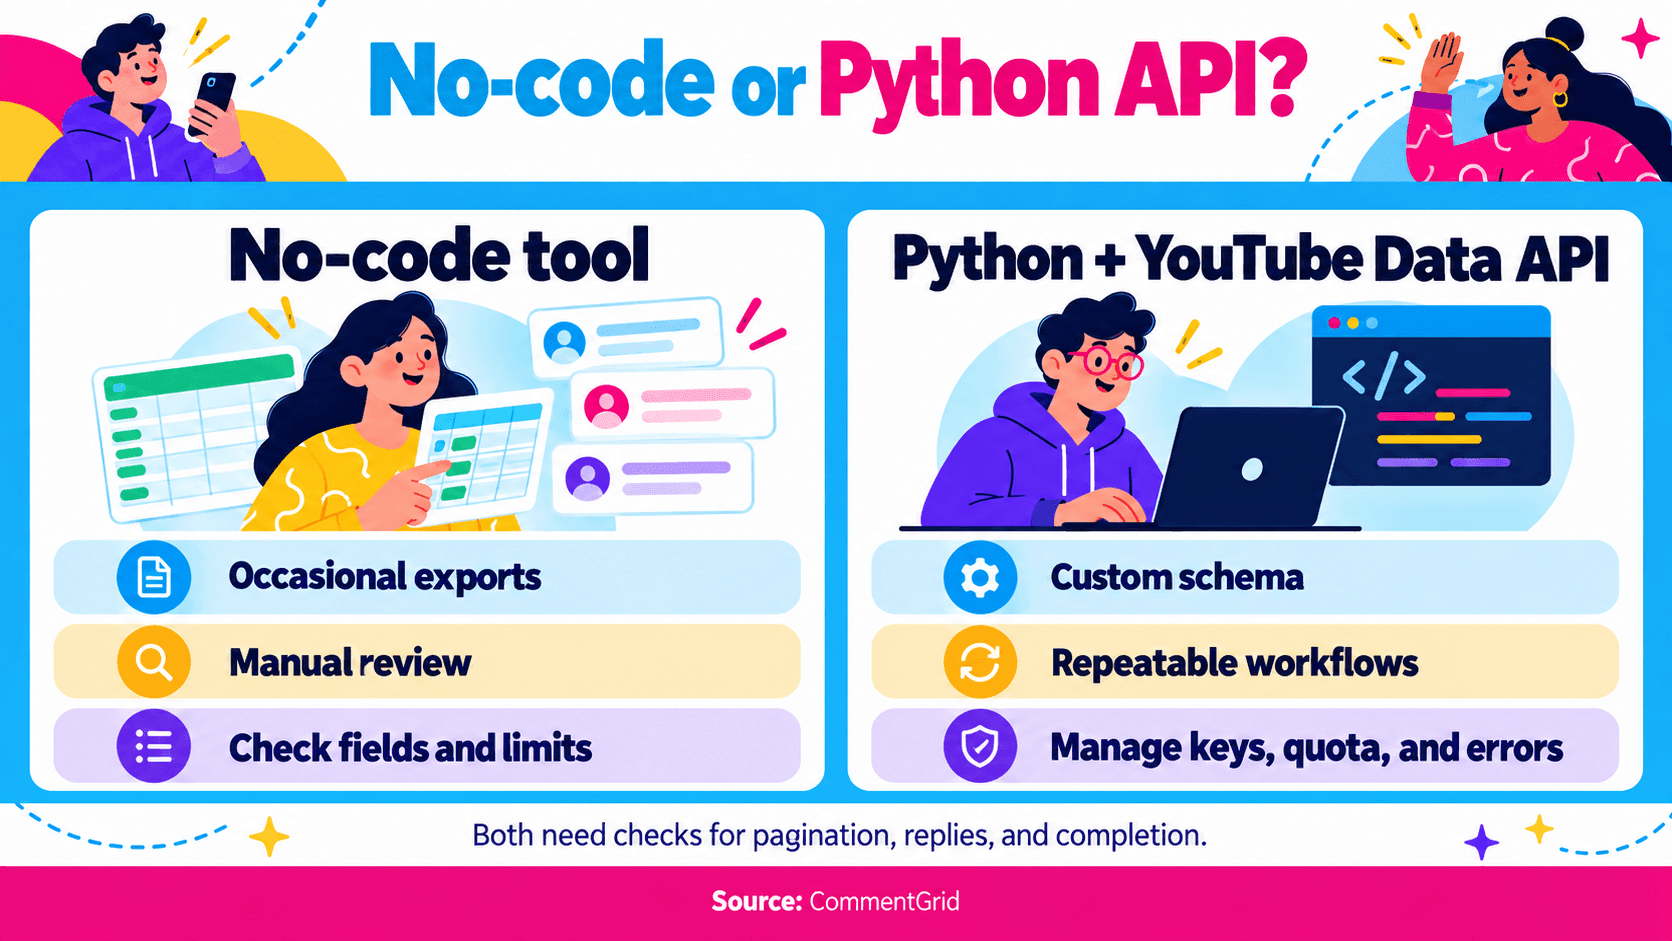
| 方法 | 適した用途 | セットアップ | 確認すべきこと |
|---|---|---|---|
| ノーコードWebツール | 手動確認用の単発データセット | 対応している動画URL。ローカルコード不要 | 返されるフィールド、返信の網羅性、現在の上限、ダウンロードオプション |
| 公式APIを使うPython | 独自スキーマと処理を備えた反復可能なワークフロー | Google Cloudプロジェクト、YouTube Data APIの有効化、APIキー、Python | ページネーション、個別の返信リクエスト、クォータ、エラー処理 |
| YouTubeのWebレスポンスを読み取るPythonパッケージ | その収集方法をメンテナーが評価済みのプロジェクト | パッケージ固有の依存関係と継続的なメンテナンス | 最近の修正、収集動作、プラットフォーム要件、失敗報告 |
1本の動画の下にある質問を確認するクリエイターは、今日ファイルが必要かもしれません。毎週同じ動画群を比較する研究者は、コード、収集ログ、一貫したスキーマが必要かもしれません。
「スクレイパー」はコメント収集ツール全般を広く指すことがよくあります。以下のPython例は、視聴ページを解析するのではなく、YouTubeの文書化されたAPIを使用します。
ノーコードのYouTubeコメントスクレイパーが適している場合
データ収集がより大きな作業のごく一部である場合、ノーコードツールを使用します。たとえば、製品フィードバックを読む、視聴者の質問を見つける、キャンペーンレポートを準備する場合です。
CommentGrid YouTubeコメントエクスポーターでは、動画ごとに最大10件のコメントを無料でエクスポートでき、CSVとJSONでダウンロードできます。YouTube APIキーを設定したり拡張機能をインストールしたりせずに、Webツールを試せます。より多いコメントのエクスポートには、デスクトップコンピューターでCommentGrid Chrome拡張機能を使用してください。
大規模な収集に着手する前に、小規模な結果を確認してください:
- 必要なテキスト、投稿者情報、タイムスタンプ、エンゲージメントのフィールドが含まれていますか?
- 返信テキストが含まれていますか、それとも表には返信数のみが表示されていますか?
- ツールは上限または不完全な実行を報告しますか?
ノーコードのワークフローでも、出力を確認する人が必要です。1つのツールがあらゆる動画のすべてのコメントを取得できると仮定せず、現在のツールとプランの許容量を確認してください。
デスクトップでは、個々の動画のアドレスをコピーするか、共有 → コピーを使用します。iPhoneまたはAndroidのYouTubeアプリでは、共有 → リンクをコピーを使用します。投稿と動画のリンクガイドでは、両方の方法を説明しています。
PythonでYouTubeコメントをスクレイピングする方法
フィールドを選択する、ソース識別子を保持する、結果を別の処理に渡す必要がある場合、Pythonは便利です。この例では、リクエストパラメーターとレスポンス構造が文書化されている公式YouTube Data APIを使用します。
1. APIアクセスを準備する
GoogleのYouTube Data APIスタートガイドに従って、プロジェクトを作成し、APIを有効化し、APIキーを取得します。キーは共有スクリプトやノートブックに入れず、意図した用途に制限してください。
この例は、1本の動画の公開コメントスレッドをリクエストします。チャンネル管理操作や非公開のモデレーションデータへのアクセス用のOAuthは実装していません。
Python 3が必要ですが、追加のPythonパッケージは不要です。以下のコードをyoutube_comment_scraper.pyとして保存してください。
2. 利用可能なトップレベルコメントを収集する
このスクリプトはページネーションをたどり、コメントIDごとに1件のレコードを保持し、動画IDと収集タイムスタンプを含むJSONを書き出します。収集するのはトップレベルコメントのみです。返信数はメタデータとして含まれますが、返信テキストは含まれません。
import json
import os
import re
import sys
from datetime import datetime, timezone
from getpass import getpass
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import urlopen


def collect_top_level(video_id, api_key):
    records, page_token = {}, None
    while True:
        params = {
            "part": "snippet", "videoId": video_id,
            "maxResults": 100, "order": "time",
            "textFormat": "plainText", "key": api_key,
        }
        if page_token:
            params["pageToken"] = page_token
        url = "https://www.googleapis.com/youtube/v3/commentThreads?"
        with urlopen(url + urlencode(params), timeout=30) as response:
            page = json.load(response)
        for thread in page.get("items", []):
            comment = thread["snippet"]["topLevelComment"]
            snippet = comment["snippet"]
            records[comment["id"]] = {
                "comment_id": comment["id"],
                "text": snippet.get("textDisplay", ""),
                "author_name": snippet.get("authorDisplayName", ""),
                "author_channel_id": (snippet.get("authorChannelId") or {}).get("value", ""),
                "published_at": snippet.get("publishedAt", ""),
                "like_count": snippet.get("likeCount", 0),
                "reply_count": thread["snippet"].get("totalReplyCount", 0),
            }
        page_token = page.get("nextPageToken")
        if not page_token:
            return list(records.values())


def main():
    if len(sys.argv) != 2 or not re.fullmatch(r"[A-Za-z0-9_-]{11}", sys.argv[1]):
        raise SystemExit("Usage: python3 youtube_comment_scraper.py VIDEO_ID (11 characters)")
    video_id = sys.argv[1]
    api_key = os.environ.get("YOUTUBE_API_KEY") or getpass("YouTube API key: ")
    if not api_key.strip():
        raise SystemExit("An API key is required.")
    started_at = datetime.now(timezone.utc)
    try:
        comments = collect_top_level(video_id, api_key.strip())
    except HTTPError as error:
        try:
            reason = json.load(error)["error"]["errors"][0]["reason"]
        except (ValueError, KeyError, IndexError, TypeError):
            reason = "requestFailed"
        raise SystemExit(f"YouTube API error {error.code}: {reason}") from None
    except (URLError, TimeoutError):
        raise SystemExit("Network request failed; no new output file was written.") from None
    result = {
        "video_id": video_id,
        "collection_started_at_utc": started_at.isoformat(),
        "collection_finished_at_utc": datetime.now(timezone.utc).isoformat(),
        "scope": "top_level_comments_only",
        "comment_count": len(comments), "comments": comments,
    }
    stamp = started_at.strftime("%Y%m%dT%H%M%S%fZ")
    output = Path(f"youtube_{video_id}_{stamp}_top_level.json")
    with output.open("x", encoding="utf-8") as handle:
        json.dump(result, handle, ensure_ascii=False, indent=2)
    print(f"Saved {len(comments)} top-level comments to {output}")


if __name__ == "__main__":
    main()
ターミナルで、VIDEO_IDを動画URLの11文字のIDに置き換えて実行します:
python3 youtube_comment_scraper.py VIDEO_ID
標準の視聴URLでは、IDはv=の後ろで、後続の&パラメーターより前の値です。スクリプトはAPIキーを表示せずに入力を求めます。すでにその方法で認証情報を提供している場合は、YOUTUBE_API_KEY環境変数も受け付けます。
実行が成功するたびに、動画IDとUTCタイムスタンプを含む名前の新しいファイルが書き出されます。出力のscope値は、トップレベルコメントのみであることを示します。APIリクエストが失敗した場合、スクリプトは出力ファイルを作成する前に停止します。原因を修正して再実行してください。
これは1本の動画向けの出発点です。レコードをメモリに保持し、自動リトライ、チェックポイント、スケジューリングは追加しません。大規模な定期ジョブに使用する前に、これらを意図的に追加してください。
3. 件数を信頼する前にページネーションを理解する
commentThreads.listメソッドは、スレッドの1ページを返します。maxResultsを100に設定すると、そのページで最大100スレッドをリクエストします。1回の呼び出しですべてのコメントをリクエストするわけではありません。
レスポンスにnextPageTokenが含まれている場合、その値を次のリクエストでpageTokenとして送信します。次のトークンがない場合にループは停止します。Googleのページネーションガイドでこのパターンを説明しています。
サンプルはorder="time"とtextFormat="plainText"を使用します。データセットを狭めるキーワードフィルターは適用しません。ページネーションの実行中にコメントは変化する可能性があるため、最後のページに到達しても、その議論の永続的なアーカイブが得られるわけではありません。
4. 必要な場合は返信を個別に収集する
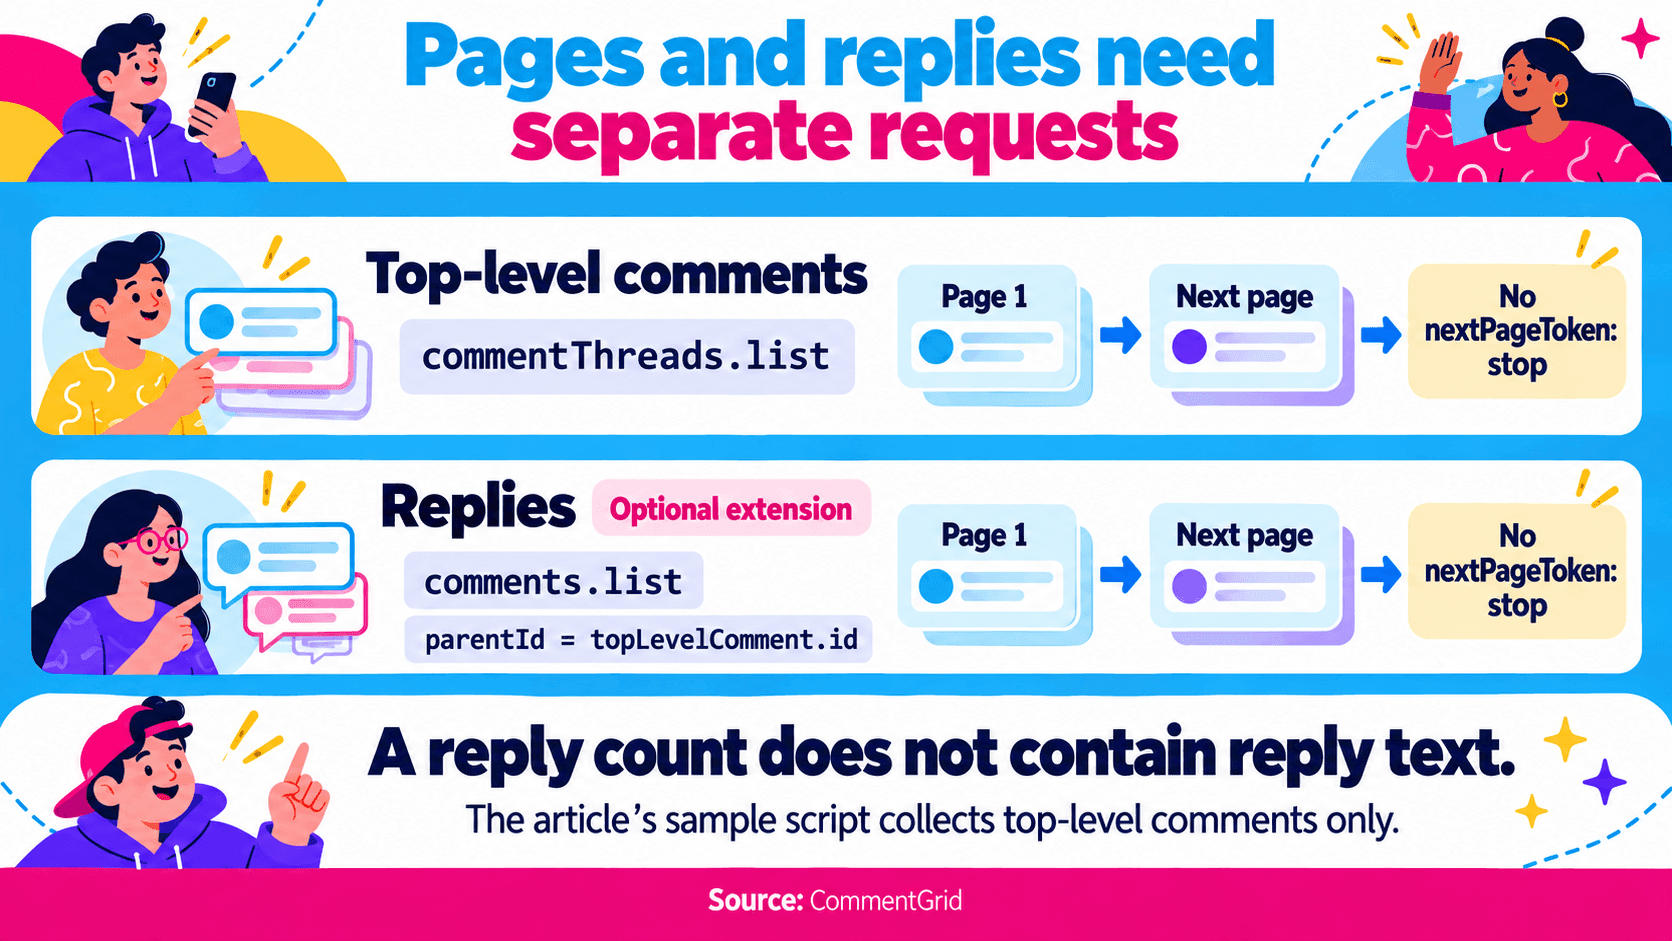 スレッドとコメントは別のレコードです。YouTubeのコメントスレッドリソースのドキュメントには、スレッドに埋め込まれた返信がすべての返信を含むとは限らないと記載されています。
返信に対応するよう例を拡張するには:
totalReplyCountがゼロではないトップレベルコメントを特定します。comments.listを、part=snippet、parentIdにそのトップレベルのコメントID、maxResults=100を指定して呼び出します。- 返信レスポンスの
nextPageTokenを、ページがなくなるまでたどります。 - 各返信自身のIDとその
parentIdを保存し、レコードを返信としてマークします。
親にはtopLevelComment.idを使用し、外側のスレッドIDが互換であると仮定しないでください。埋め込み返信もリクエストする場合は、コメントIDを使って個別に取得したレコードと重複排除してください。
たとえば、80件のトップレベルコメントと取得済みの40件の返信を含むデータセットには、120件のコメントレコードが含まれます。80行と合計40の返信数値を持つファイルでも、含まれるコメントテキストは依然として80件のみです。
5. クォータとエラーに備える
Googleのクォータ計算ツールでは現在、commentThreads.listとcomments.listの両方が1リクエストあたり1クォータ単位と記載されています。追加のページと返信リクエストはそれぞれ呼び出しを追加します。
計画目的では、すべてのページが100スレッドを返す場合、1,000件のトップレベルコメントに少なくとも10回のリクエストが必要です。返信を取得すると、該当する親コメントの分だけリクエストが追加されます。失敗したリクエストもクォータを消費する可能性があるため、無期限のリトライは避けてください。
APIのエラーリファレンスを使用して、リクエストの問題とアクセスまたはクォータの制限を区別してください:
| エラーまたは症状 | 確認すべきこと |
|---|---|
commentsDisabled | 動画でコメントが無効になっています。同じリクエストを繰り返しても有効にはなりません |
videoNotFound | 動画IDと、リクエストに対して動画が利用可能かを確認します |
forbidden | アクセス要件と認可を確認します |
| クォータ関連のエラー | 再試行する前に、プロジェクトのクォータとリクエスト使用量を確認します |
| 最初のバッチしか返されない | レスポンスに未処理の次ページトークンが含まれていないか確認します |
定期ジョブでは、どの動画とページが失敗したかをログに記録し、認証情報をログに入れず、収集が完了したかどうかを記録します。部分的なデータセットは、部分的なものとして識別できるようにする必要があります。
代わりにPythonスクレイパーパッケージを使うべきか?
一部のPythonプロジェクトは、ユーザーがData APIキーを提供しなくても、YouTubeのWebレスポンスからコメントを収集します。これにより初期のAPIセットアップを減らせますが、プロジェクトの収集方法とメンテナンスへの依存が生じます。
古いチュートリアルのスクリプトを採用する前に、リポジトリを確認してください。たとえば、BellingcatのYouTubeコメントスクレイパーリポジトリは2025年1月21日にアーカイブされました。これは、それを中心に新しいワークフローを構築する前に依存関係と代替手段を調べる理由になりますが、その中のすべてのコマンドが動作しなくなった証拠ではありません。
パッケージでも独自スクリプトでも、ページネーション、返信、重複ID、失敗したリクエストが明確に処理されているかを確認してください。選択した収集方法について、該当するプラットフォームの規約とAPIポリシーを確認してください。APIキー要件がないことは、無制限または制約のないアクセスを保証するものではありません。
スクレイピングしたYouTubeコメントデータセットを確認する方法
ファイルがノーコードツールから来たものでもPythonから来たものでも、同じチェックを使用してください。
| チェック | 記録または確認すること |
|---|---|
| ソース | 動画URLまたはID、および収集開始と終了の時刻 |
| スコープ | トップレベルコメントのみ、またはトップレベルコメントと取得済み返信 |
| 完了状況 | すべてのリクエスト済みページが完了したか、上限に達したか、エラーで実行が停止したか |
| 識別情報 | レコードのコメントID。必要かつ利用可能な場合は投稿者チャンネルID |
| コンテキスト | 親コメントとの関係、および利用可能な場合はソースへのリンク |
これらはデータセットに適用するチェックであり、すべてのツールがこれらのフィールドを自動的に作成することを保証するものではありません。
いくつかのコメントを動画と照合して確認し、返信のあるスレッドを少なくとも1つ開いてください。質問や感情を測定している場合は、短い返信が親コメントと並べても意味が通ることを確認してください。
参加者ごとに1行が必要である場合を除き、投稿者で重複排除しないでください。1人が複数の異なるコメントを書くことがあります。繰り返し収集する場合は、収集時刻を(video_id, comment_id)と一緒に保持し、いいねやテキストの変化を重複レコードと区別できるようにしてください。
ファイルのスコープを信頼できるようになったら、YouTubeコメント検索ガイドを使用して、エクスポートしたデータ内のキーワードや投稿者を検索してください。コンテストの応募作品については、別のYouTubeコメントから当選者を選ぶ方法ガイドに従ってください。そこでは応募ルールによって、繰り返しコメントした人をどう数えるかが決まります。
よくある質問
APIキーなしでYouTubeコメントをスクレイピングできますか?
はい。CommentGridのWebツールでは、YouTube APIキーを提供する必要はありません。このガイドのPython API例では、ご自身のキーが必要です。その他のパッケージには、それぞれのセットアップとアクセス要件があります。
YouTubeコメントスクレイパーはすべてのコメントを取得できますか?
取得できると仮定しないでください。ページネーション、返信収集、処理上限、失敗を確認してください。削除されたコメント、モデレーションされたコメント、アクセスできないコメントは含まれない可能性があり、収集中に議論が変化することがあります。結果は、実際の収集スコープと時刻を用いて説明してください。
返信数があれば返信もスクレイピングされたことになりますか?
いいえ。件数はスレッドを説明するものであり、返信テキストを含むものではありません。公式APIでは、それらのレコードが必要な場合、個別のページ分割された返信リクエストを使用します。上記のサンプルスクリプトは、これらのリクエストを行いません。
Python例はYouTubeライブチャットを収集しますか?
いいえ。動画のコメントスレッドをリクエストします。ライブチャットメッセージは別のAPIリソースを使用し、異なる収集ワークフローが必要です。
Pythonはノーコードツールより優れていますか?
リクエスト、スキーマ、繰り返し実行を制御する価値がセットアップとメンテナンスに見合う場合にPythonを使用します。ダウンロード可能なデータセットと手動確認で作業を満たせる場合は、ノーコードツールを使用します。どちらも、欠落レコードと返信の網羅性を確認する必要があります。
CommentGridでYouTubeコメントをさらにエクスポート
デスクトップ版ChromeのCommentGridで、より高いエクスポート上限を利用できます。登録すると300クレジットを無料で受け取れます。
CommentGridをChromeに追加まず試してみたいですか?無料のYouTube Webツールを試す。
 M
Marshall Sun
Building CommentGrid to decode social conversations. Exploring the signal within the noise of the global social web.