10 分鐘閱讀
YouTube 留言爬取工具會把影片中的留言收集成紀錄,讓你能搜尋、分析或以程式處理。若只是偶爾整理成試算表,無程式碼工具通常是開始最快的方式。若你需要自訂並重複執行的工作流程,使用 YouTube Data API 的 Python 可讓你控制請求與輸出。
選擇方法前,請確認它是否會收集回覆、是否會追蹤每一個結果頁,以及是否會回報失敗的請求。這些細節會決定你能從資料中得出什麼結論。
本指南會比較這些方法,並提供一個針對頂層留言的 Python 範例。如果你已確定要使用試算表,請依照我們的 YouTube 留言匯出教學 進行下載與 Excel 操作。
你該使用哪種 YouTube 留言爬取方法?
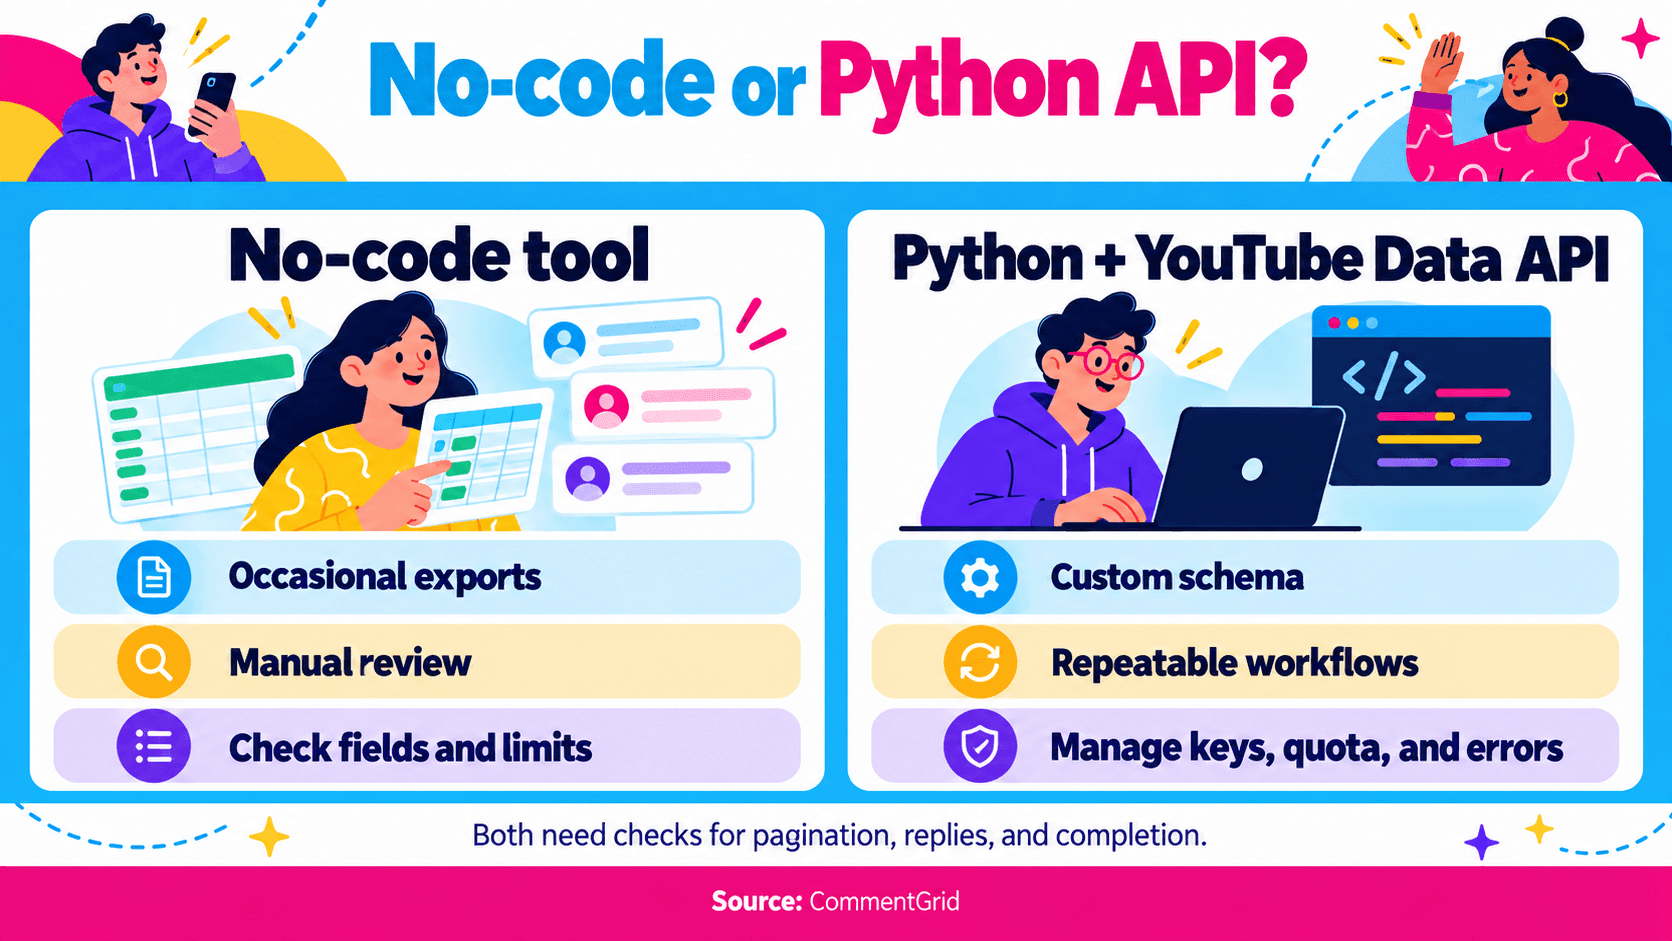
| 方法 | 適合情境 | 設定 | 需要檢查的事項 |
|---|---|---|---|
| 無程式碼網頁工具 | 供人工檢視的一次性資料集 | 支援的影片網址;不需在本機寫程式 | 回傳欄位、回覆涵蓋範圍、目前限制與下載選項 |
| 使用官方 API 的 Python | 使用自有結構與處理方式的可重複工作流程 | Google Cloud 專案、已啟用的 YouTube Data API、API 金鑰與 Python | 分頁、另開回覆請求、配額與錯誤處理 |
| 讀取 YouTube 網頁回應的 Python 套件 | 由維護者評估過該收集方法的專案 | 套件特定相依性與持續維護 | 近期修正、收集行為、平台需求與失敗回報 |
創作者若只想檢視單支影片底下的問題,可能今天就需要一個檔案。研究者若每週比較同一組影片,則可能需要程式、收集日誌與一致的資料結構。
「Scraper」常被廣泛用來指稱留言收集工具。下方的 Python 範例使用 YouTube 官方文件的 API,而不是解析觀看頁面。
何時適合使用無程式碼 YouTube 留言爬取工具
當收集資料只是更大任務的一小部分時,例如閱讀產品回饋、找出觀眾問題或準備活動報告,就適合使用無程式碼工具。
CommentGrid YouTube 留言匯出工具 可讓你每支影片免費匯出最多 10 則留言,並提供 CSV 與 JSON 下載。你不需要設定 YouTube API 金鑰或安裝擴充功能,就能試用這個網頁工具。若需要匯出更多留言,請在桌上型電腦使用 CommentGrid Chrome 擴充功能。
在投入大規模收集前,請先檢查一小批結果:
- 是否包含你需要的文字、作者資訊、時間戳記與互動欄位?
- 是否包含回覆文字,或表格只顯示回覆數量?
- 工具是否會回報限制或不完整的執行結果?
無程式碼工作流程仍然需要有人檢視輸出。請檢查目前工具與方案允許的範圍,不要假設單一工具能擷取每支影片的每一則留言。
在桌機上,請複製個別影片的網址,或使用 分享 → 複製。在 iPhone 或 Android 的 YouTube 應用程式中,請使用 分享 → 複製連結。我們的 貼文與影片連結指南 涵蓋這兩種方式。
如何使用 Python 爬取 YouTube 留言
當你需要選擇欄位、保留來源識別碼,或把結果送入另一個流程時,Python 會很有用。本範例使用官方 YouTube Data API,讓請求參數與回應結構都有官方文件可循。
1. 準備 API 存取權
請依照 Google 的 YouTube Data API 入門指南 建立專案、啟用 API 並取得 API 金鑰。請勿把金鑰放在共用腳本與 Notebook 中,並依預期用途限制金鑰。
此範例會請求單一影片的公開留言討論串。它不會實作 OAuth,因此不能用於頻道管理操作,也無法存取非公開的審核資料。
你需要 Python 3,但不需要額外的 Python 套件。請將下方程式碼存成 youtube_comment_scraper.py。
2. 收集可取得的頂層留言
此腳本會追蹤分頁、每個留言 ID 只保留一筆紀錄,並寫出包含影片 ID 與收集時間戳記的 JSON。它只收集頂層留言。回覆數量會作為中繼資料納入;不會包含回覆文字。
import json
import os
import re
import sys
from datetime import datetime, timezone
from getpass import getpass
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import urlopen


def collect_top_level(video_id, api_key):
    records, page_token = {}, None
    while True:
        params = {
            "part": "snippet", "videoId": video_id,
            "maxResults": 100, "order": "time",
            "textFormat": "plainText", "key": api_key,
        }
        if page_token:
            params["pageToken"] = page_token
        url = "https://www.googleapis.com/youtube/v3/commentThreads?"
        with urlopen(url + urlencode(params), timeout=30) as response:
            page = json.load(response)
        for thread in page.get("items", []):
            comment = thread["snippet"]["topLevelComment"]
            snippet = comment["snippet"]
            records[comment["id"]] = {
                "comment_id": comment["id"],
                "text": snippet.get("textDisplay", ""),
                "author_name": snippet.get("authorDisplayName", ""),
                "author_channel_id": (snippet.get("authorChannelId") or {}).get("value", ""),
                "published_at": snippet.get("publishedAt", ""),
                "like_count": snippet.get("likeCount", 0),
                "reply_count": thread["snippet"].get("totalReplyCount", 0),
            }
        page_token = page.get("nextPageToken")
        if not page_token:
            return list(records.values())


def main():
    if len(sys.argv) != 2 or not re.fullmatch(r"[A-Za-z0-9_-]{11}", sys.argv[1]):
        raise SystemExit("Usage: python3 youtube_comment_scraper.py VIDEO_ID (11 characters)")
    video_id = sys.argv[1]
    api_key = os.environ.get("YOUTUBE_API_KEY") or getpass("YouTube API key: ")
    if not api_key.strip():
        raise SystemExit("An API key is required.")
    started_at = datetime.now(timezone.utc)
    try:
        comments = collect_top_level(video_id, api_key.strip())
    except HTTPError as error:
        try:
            reason = json.load(error)["error"]["errors"][0]["reason"]
        except (ValueError, KeyError, IndexError, TypeError):
            reason = "requestFailed"
        raise SystemExit(f"YouTube API error {error.code}: {reason}") from None
    except (URLError, TimeoutError):
        raise SystemExit("Network request failed; no new output file was written.") from None
    result = {
        "video_id": video_id,
        "collection_started_at_utc": started_at.isoformat(),
        "collection_finished_at_utc": datetime.now(timezone.utc).isoformat(),
        "scope": "top_level_comments_only",
        "comment_count": len(comments), "comments": comments,
    }
    stamp = started_at.strftime("%Y%m%dT%H%M%S%fZ")
    output = Path(f"youtube_{video_id}_{stamp}_top_level.json")
    with output.open("x", encoding="utf-8") as handle:
        json.dump(result, handle, ensure_ascii=False, indent=2)
    print(f"Saved {len(comments)} top-level comments to {output}")


if __name__ == "__main__":
    main()
在終端機中執行,並將 VIDEO_ID 替換為影片網址中的 11 字元 ID:
python3 youtube_comment_scraper.py VIDEO_ID
若是一般的觀看網址,ID 是 v= 之後、任何後續 & 參數之前的值。腳本會提示你輸入 API 金鑰,但不會顯示金鑰。如果你原本就透過環境變數提供憑證,它也接受 YOUTUBE_API_KEY 環境變數。
每次成功執行都會寫出一個新檔案,檔名包含影片 ID 與 UTC 時間戳記。輸出的 scope 值會標示它只包含頂層留言。如果 API 請求失敗,腳本會在建立輸出檔案前停止;請修正原因後重新執行。
這是針對單一影片的起點。它會把紀錄保存在記憶體中,不會加入自動重試、檢查點或排程。若要用於大規模且重複執行的工作,請先刻意加入這些機制。
3. 信任數量前先了解分頁
commentThreads.list 方法 會回傳一頁討論串。將 maxResults 設為 100,會請求該頁最多 100 個討論串。它不會在一次呼叫中請求每一則留言。
當回應包含 nextPageToken 時,請在下一次請求中將該值作為 pageToken 送出。沒有下一個權杖時,迴圈就會停止。Google 的 分頁指南 說明了這個模式。
範例使用 order="time" 與 textFormat="plainText"。它不會套用關鍵字篩選,因為那會縮小資料集。分頁執行期間留言可能變動,因此即使跑到最後一頁,仍不會產生討論的永久封存。
4. 需要回覆時另行收集
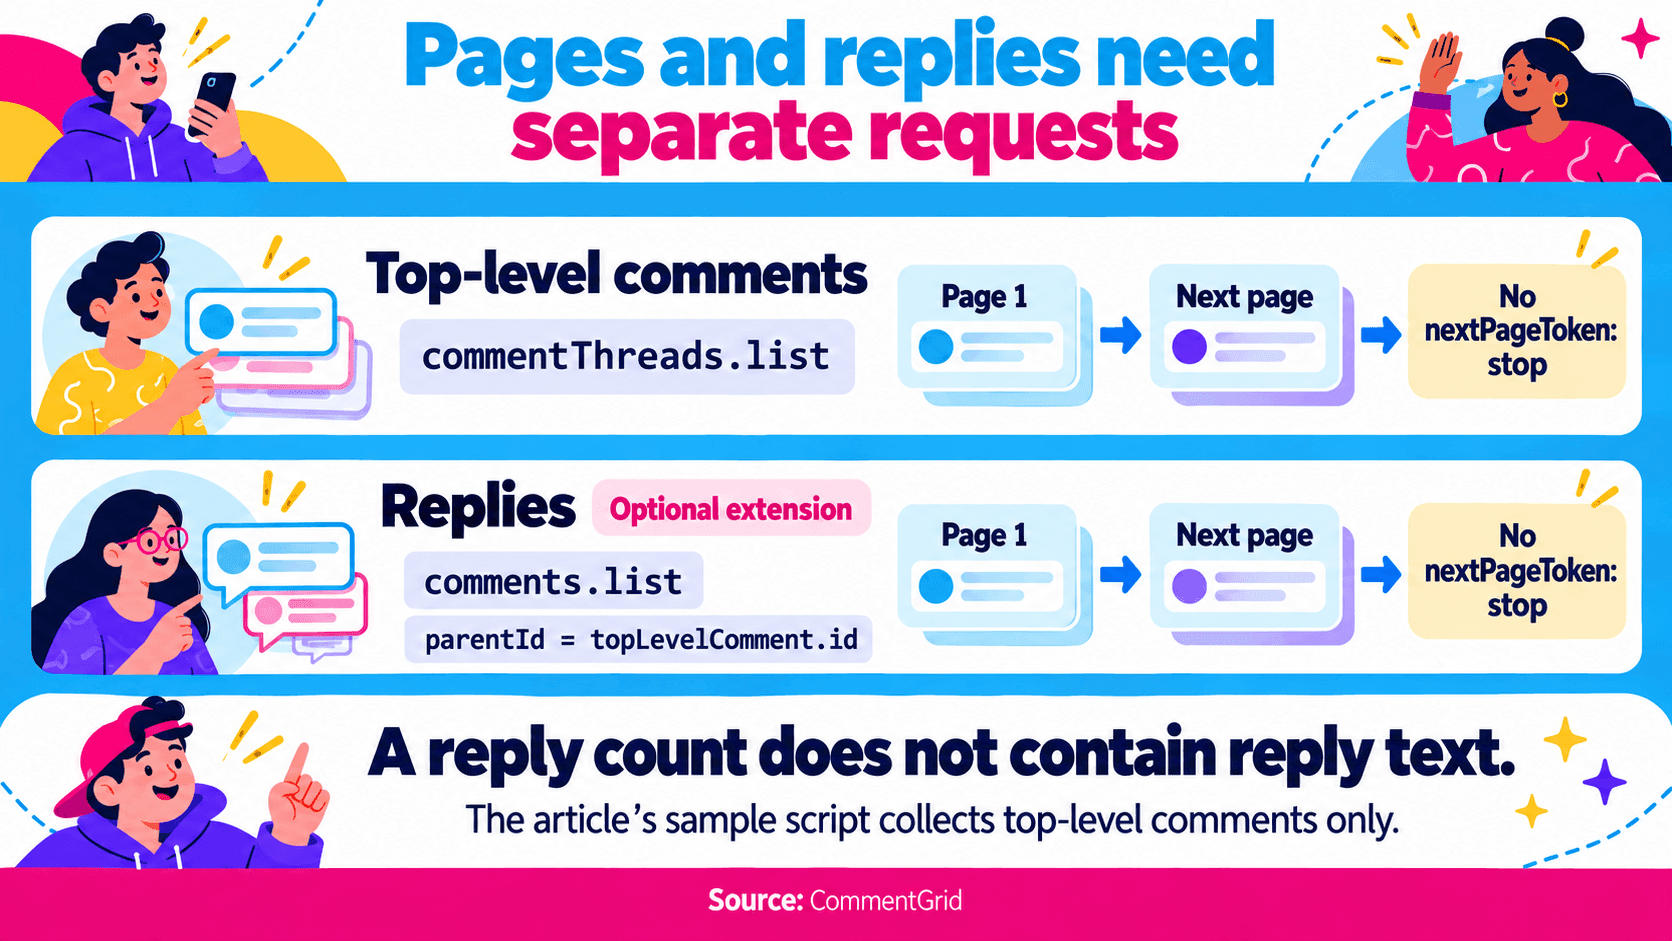
討論串與留言是不同的紀錄。YouTube 的 留言討論串資源文件 指出,討論串中內嵌的回覆不一定包含每一則回覆。
若要擴充範例以收集回覆:
- 找出
totalReplyCount不為零的頂層留言。 - 呼叫
comments.list,將part=snippet、parentId設為該頂層留言 ID,並設定maxResults=100。 - 依照回覆回應中的
nextPageToken繼續前進,直到沒有更多頁面。 - 儲存每則回覆自己的 ID 與其
parentId,並將該紀錄標記為回覆。
父項請使用 topLevelComment.id,不要假設外層討論串 ID 可以互換。如果你也請求內嵌回覆,請使用留言 ID 將它們與另行取得的紀錄去除重複。
例如,一個包含 80 則頂層留言與 40 則已取得回覆的資料集,會有 120 筆留言紀錄。一個有 80 列、回覆數量加總為 40 的檔案,仍然只包含 80 則留言文字。
5. 規劃配額與錯誤處理
Google 的 配額計算工具 目前將 commentThreads.list 與 comments.list 都列為每次請求 1 個配額單位。額外頁面與回覆請求都會各自增加呼叫次數。
以規劃而言,若每頁都回傳 100 個討論串,1,000 則頂層留言至少需要 10 次請求。取得回覆會針對相關父項增加請求。失敗的請求也可能消耗配額,因此請避免無限重試。
請使用 API 的 錯誤參考文件 來區分請求問題與存取或配額限制:
| 錯誤或徵兆 | 應檢查的事項 |
|---|---|
commentsDisabled | 影片已停用留言;重複送出相同請求不會啟用留言 |
videoNotFound | 確認影片 ID,以及該影片是否可供此請求存取 |
forbidden | 檢查存取需求與授權 |
| 配額相關錯誤 | 重試前先檢查專案配額與請求用量 |
| 只回傳第一批 | 檢查回應是否包含尚未處理的下一頁權杖 |
對於重複執行的工作,請記錄是哪支影片與哪一頁失敗、不要讓憑證出現在日誌中,並記錄收集是否完成。部分資料集應能被辨識為部分資料。
你應該改用 Python 爬取套件嗎?
有些 Python 專案會從 YouTube 的網頁回應收集留言,且不要求使用者提供 Data API 金鑰。這能減少一開始的 API 設定,但也會讓你依賴該專案的收集方法與維護狀況。
採用舊教學中的腳本前,請先檢查其儲存庫。例如,Bellingcat YouTube 留言爬取器儲存庫 已於 2025 年 1 月 21 日封存。這是你在圍繞它建立新工作流程前,應檢查其相依性與替代方案的理由;但這不代表其中每個指令都已停止運作。
無論是套件或你自己的腳本,都要尋找對分頁、回覆、重複 ID 與失敗請求的清楚處理方式。請檢查你所選收集方法適用的平台條款與 API 政策。沒有 API 金鑰要求,並不代表能無限或不受限制地存取。
如何檢查爬取到的 YouTube 留言資料集
無論檔案來自無程式碼工具或 Python,都請使用相同的檢查。
| 檢查項目 | 應記錄或檢視的內容 |
|---|---|
| 來源 | 影片網址或 ID,以及收集開始與結束時間 |
| 範圍 | 僅頂層留言,或頂層留言與已取得的回覆 |
| 完成狀態 | 每個請求頁面是否都完成、是否達到限制,或是否有錯誤中止執行 |
| 識別 | 紀錄的留言 ID;必要且可用時,記錄作者頻道 ID |
| 脈絡 | 父留言關係,以及可用時連回來源的連結 |
這些是套用到資料集上的檢查,並不保證每個工具都會自動建立所有這些欄位。
請對照影片檢查幾則留言,並至少開啟一個含有回覆的討論串。如果你要衡量問題或情緒,請確認簡短回覆與其父留言放在一起時仍說得通。
除非你明確想要每位參與者只保留一列,否則不要依作者去除重複。同一個人可以寫下好幾則不同留言。對於重複收集,請將收集時間與 (video_id, comment_id) 一起保留,這樣按讚數或文字的變化才能與重複紀錄區分開來。
當你信任檔案的範圍後,請使用我們的 YouTube 留言搜尋指南 在匯出資料中尋找關鍵字或作者。若是抽獎參賽留言,請依照另一篇 從 YouTube 留言選出得獎者 的指南;其中參賽規則會決定重複留言者該如何計算。
常見問題
我可以在沒有 API 金鑰的情況下爬取 YouTube 留言嗎?
可以。CommentGrid 的網頁工具不要求你提供 YouTube API 金鑰。本指南中的 Python API 範例則需要你自己的金鑰。其他套件有各自的設定與存取要求。
YouTube 留言爬取工具能取得每一則留言嗎?
不要假設它可以。請檢查分頁、回覆收集、處理限制與失敗情況。已刪除、遭審核或無法存取的留言可能不會出現,而且收集期間討論也可能變動。請用實際的收集範圍與時間來描述結果。
回覆數量代表回覆已被爬取嗎?
不代表。數量描述的是討論串,並不包含回覆文字。使用官方 API 時,若需要那些紀錄,請另行發出分頁的回覆請求。上方的範例腳本不會發出這些請求。
Python 範例會收集 YouTube 直播聊天室嗎?
不會。它請求的是影片留言討論串。直播聊天室訊息 使用不同的 API 資源,需要不同的收集工作流程。
Python 比無程式碼工具更好嗎?
當控制請求、結構與重複執行值得投入設定與維護時,請使用 Python。當可下載的資料集與人工檢視就能滿足任務時,請使用無程式碼工具。兩者都需要檢查是否有缺漏紀錄與回覆涵蓋範圍。
使用 CommentGrid 匯出更多 YouTube 留言
在桌面版 Chrome 中使用 CommentGrid 取得更高的匯出上限。註冊即可獲得 300 個免費點數。
將 CommentGrid 加入 Chrome想先試用嗎?試用免費 YouTube 網頁工具。
 M
Marshall Sun
Building CommentGrid to decode social conversations. Exploring the signal within the noise of the global social web.