10 min de lectura
Un extractor de comentarios de YouTube recopila los comentarios de un video en registros que puedes buscar, analizar o procesar en código. Para una hoja de cálculo ocasional, una herramienta sin código suele ser el punto de partida más rápido. Para un flujo de trabajo que necesitas personalizar y ejecutar repetidamente, Python con la API de datos de YouTube te da control sobre las solicitudes y la salida.
Antes de elegir un método, comprueba si recopila respuestas, recorre todas las páginas de resultados y notifica las solicitudes fallidas. Esos detalles determinan lo que puedes concluir de los datos.
Esta guía compara los métodos e incluye un ejemplo en Python para comentarios de nivel superior. Si ya sabes que quieres una hoja de cálculo, sigue nuestro tutorial para exportar comentarios de YouTube para los pasos de descarga y Excel.
¿Qué método de extracción de comentarios de YouTube deberías usar?
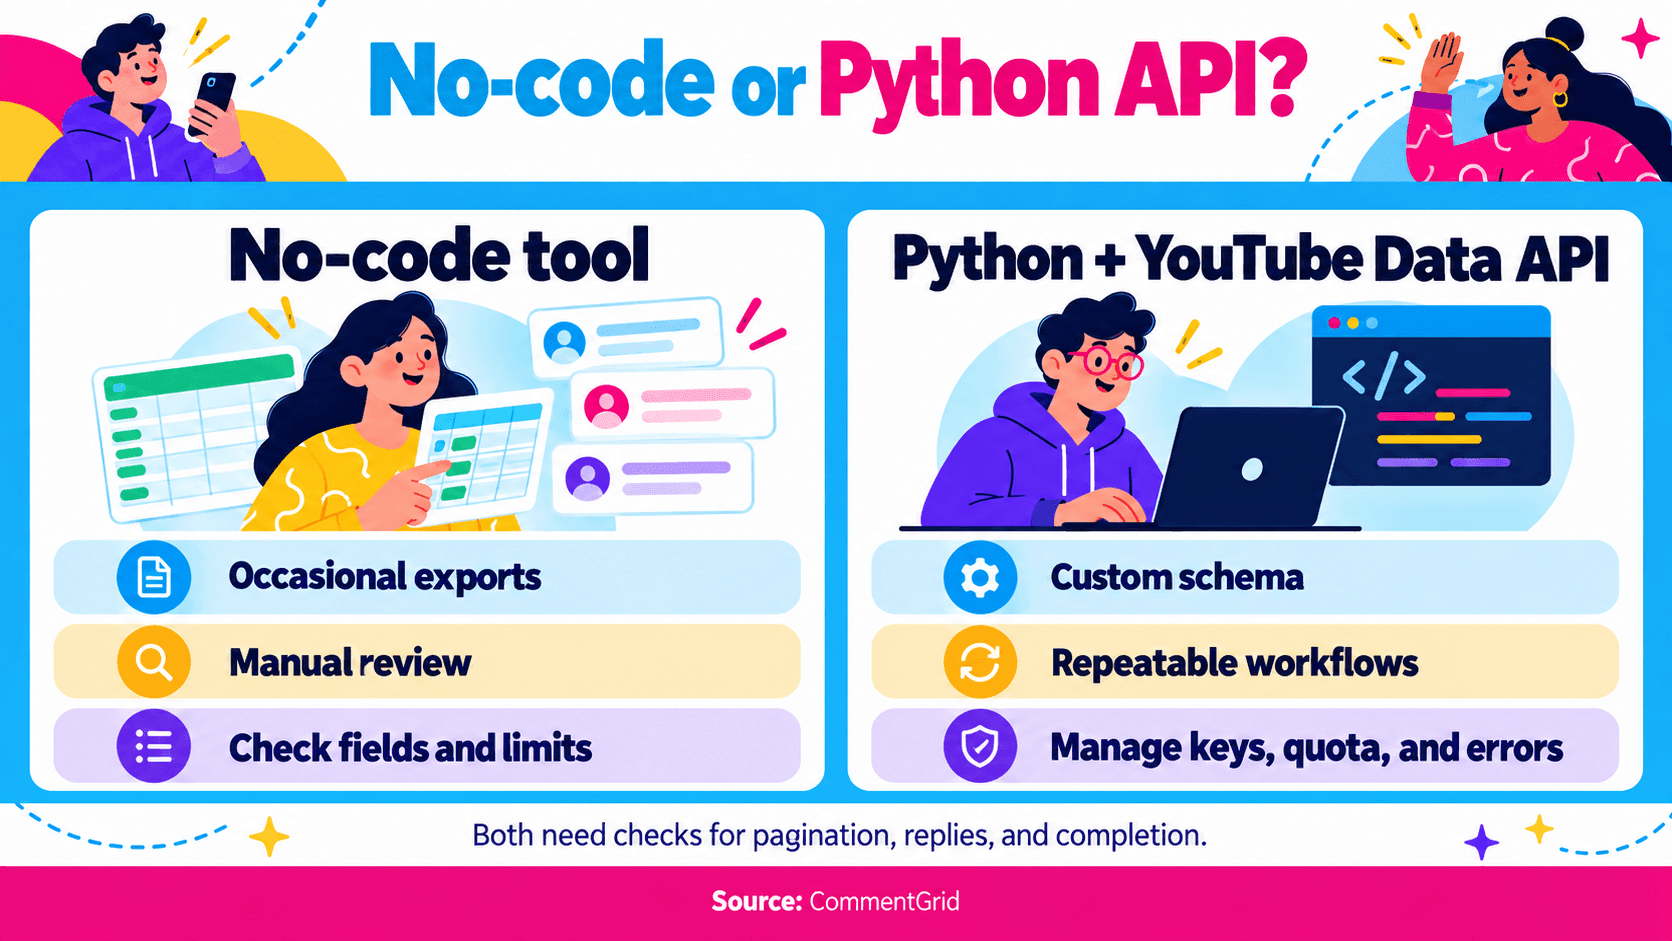
| Método | Cuándo conviene | Configuración | Qué debes comprobar |
|---|---|---|---|
| Herramienta web sin código | Un conjunto de datos puntual para revisión manual | Una URL de video compatible; sin código local | Campos devueltos, cobertura de respuestas, límites actuales y opciones de descarga |
| Python con la API oficial | Un flujo de trabajo repetible con tu propio esquema y procesamiento | Proyecto de Google Cloud, API de datos de YouTube habilitada, clave de API y Python | Paginación, solicitudes de respuestas separadas, cuota y manejo de errores |
| Paquete de Python que lee las respuestas web de YouTube | Un proyecto cuyo mantenedor haya evaluado ese método de recopilación | Dependencias específicas del paquete y mantenimiento continuo | Correcciones recientes, comportamiento de recopilación, requisitos de plataforma y notificación de fallos |
Un creador que revisa preguntas bajo un solo video puede necesitar un archivo hoy. Un investigador que compara el mismo conjunto de videos cada semana puede necesitar código, registros de recopilación y un esquema consistente.
“Scraper” se usa a menudo de forma amplia para las herramientas de recopilación de comentarios. El ejemplo de Python a continuación usa la API documentada de YouTube en lugar de analizar la página de visualización.
Cuándo tiene sentido un extractor de comentarios de YouTube sin código
Usa una herramienta sin código cuando recopilar los datos sea una parte pequeña de una tarea más amplia: leer comentarios de productos, encontrar preguntas de la audiencia o preparar un informe de campaña.
El exportador de comentarios de YouTube de CommentGrid te permite exportar hasta 10 comentarios por video de forma gratuita, con descargas en CSV y JSON. Puedes probar la herramienta web sin configurar una clave de API de YouTube ni instalar una extensión. Para exportaciones de comentarios más grandes, usa la extensión de Chrome de CommentGrid en una computadora de escritorio.
Antes de comprometerte con una recopilación grande, revisa un resultado pequeño:
- ¿Contiene el texto, la información del autor, las marcas de tiempo y los campos de interacción que necesitas?
- ¿Están presentes los textos de las respuestas o la tabla solo muestra un recuento de respuestas?
- ¿La herramienta informa un límite o una ejecución incompleta?
Un flujo de trabajo sin código todavía necesita que alguien revise la salida. Comprueba las capacidades y los límites actuales de la herramienta y del plan, en lugar de asumir que una herramienta puede recuperar todos los comentarios de todos los videos.
En computadora de escritorio, copia la dirección del video individual o usa Compartir → Copiar. En la aplicación de YouTube en iPhone o Android, usa Compartir → Copiar enlace. Nuestra guía de enlaces de publicaciones y videos cubre ambas rutas.
Cómo extraer comentarios de YouTube con Python
Python es útil cuando necesitas elegir los campos, conservar los identificadores de origen o introducir los resultados en otro proceso. Para este ejemplo, usa la API oficial de datos de YouTube para que los parámetros de solicitud y la estructura de respuesta estén documentados.
1. Prepara tu acceso a la API
Sigue la guía de introducción a la API de datos de YouTube de Google para crear un proyecto, habilitar la API y obtener una clave de API. Mantén la clave fuera de scripts y cuadernos compartidos, y restríngela para el uso previsto.
El ejemplo solicita hilos de comentarios públicos de un video. No implementa OAuth para operaciones de gestión de canales ni acceso a datos de moderación no públicos.
Necesitas Python 3, pero no paquetes adicionales de Python. Guarda el código de abajo como youtube_comment_scraper.py.
2. Recopila los comentarios de nivel superior disponibles
El script sigue la paginación, conserva un registro por ID de comentario y escribe JSON con el ID del video y las marcas de tiempo de recopilación. Solo recopila comentarios de nivel superior. Los recuentos de respuestas se incluyen como metadatos; los textos de las respuestas no.
import json
import os
import re
import sys
from datetime import datetime, timezone
from getpass import getpass
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import urlopen


def collect_top_level(video_id, api_key):
    records, page_token = {}, None
    while True:
        params = {
            "part": "snippet", "videoId": video_id,
            "maxResults": 100, "order": "time",
            "textFormat": "plainText", "key": api_key,
        }
        if page_token:
            params["pageToken"] = page_token
        url = "https://www.googleapis.com/youtube/v3/commentThreads?"
        with urlopen(url + urlencode(params), timeout=30) as response:
            page = json.load(response)
        for thread in page.get("items", []):
            comment = thread["snippet"]["topLevelComment"]
            snippet = comment["snippet"]
            records[comment["id"]] = {
                "comment_id": comment["id"],
                "text": snippet.get("textDisplay", ""),
                "author_name": snippet.get("authorDisplayName", ""),
                "author_channel_id": (snippet.get("authorChannelId") or {}).get("value", ""),
                "published_at": snippet.get("publishedAt", ""),
                "like_count": snippet.get("likeCount", 0),
                "reply_count": thread["snippet"].get("totalReplyCount", 0),
            }
        page_token = page.get("nextPageToken")
        if not page_token:
            return list(records.values())


def main():
    if len(sys.argv) != 2 or not re.fullmatch(r"[A-Za-z0-9_-]{11}", sys.argv[1]):
        raise SystemExit("Usage: python3 youtube_comment_scraper.py VIDEO_ID (11 characters)")
    video_id = sys.argv[1]
    api_key = os.environ.get("YOUTUBE_API_KEY") or getpass("YouTube API key: ")
    if not api_key.strip():
        raise SystemExit("An API key is required.")
    started_at = datetime.now(timezone.utc)
    try:
        comments = collect_top_level(video_id, api_key.strip())
    except HTTPError as error:
        try:
            reason = json.load(error)["error"]["errors"][0]["reason"]
        except (ValueError, KeyError, IndexError, TypeError):
            reason = "requestFailed"
        raise SystemExit(f"YouTube API error {error.code}: {reason}") from None
    except (URLError, TimeoutError):
        raise SystemExit("Network request failed; no new output file was written.") from None
    result = {
        "video_id": video_id,
        "collection_started_at_utc": started_at.isoformat(),
        "collection_finished_at_utc": datetime.now(timezone.utc).isoformat(),
        "scope": "top_level_comments_only",
        "comment_count": len(comments), "comments": comments,
    }
    stamp = started_at.strftime("%Y%m%dT%H%M%S%fZ")
    output = Path(f"youtube_{video_id}_{stamp}_top_level.json")
    with output.open("x", encoding="utf-8") as handle:
        json.dump(result, handle, ensure_ascii=False, indent=2)
    print(f"Saved {len(comments)} top-level comments to {output}")


if __name__ == "__main__":
    main()
Ejecútalo en una terminal, reemplazando VIDEO_ID por el ID de 11 caracteres de la URL del video:
python3 youtube_comment_scraper.py VIDEO_ID
Para una URL de visualización estándar, el ID es el valor que aparece después de v= y antes de cualquier parámetro & posterior. El script solicita tu clave de API sin mostrarla. También acepta una variable de entorno YOUTUBE_API_KEY si ya proporcionas credenciales de esa forma.
Cada ejecución correcta escribe un archivo nuevo con el nombre formado por el ID del video y una marca de tiempo UTC. El valor scope de la salida lo identifica como solo comentarios de nivel superior. Si falla una solicitud a la API, el script se detiene antes de crear un archivo de salida; corrige la causa y vuelve a ejecutarlo.
Este es un punto de partida para un video. Mantiene los registros en memoria y no añade reintentos automáticos, puntos de control ni programación. Añádelos de forma deliberada antes de usarlo para trabajos recurrentes grandes.
3. Comprende la paginación antes de confiar en el recuento
El método commentThreads.list devuelve una página de hilos. Establecer maxResults en 100 solicita hasta 100 hilos para esa página. No solicita todos los comentarios en una sola llamada.
Cuando la respuesta incluye nextPageToken, envía ese valor como pageToken en la siguiente solicitud. El bucle se detiene cuando no hay un token siguiente. La guía de paginación de Google explica este patrón.
El ejemplo usa order="time" y textFormat="plainText". No aplica un filtro de palabras clave, que reduciría el conjunto de datos. Los comentarios pueden cambiar mientras se ejecuta la paginación, por lo que llegar a la última página tampoco produce un archivo permanente de la conversación.
4. Recopila las respuestas por separado cuando las necesites
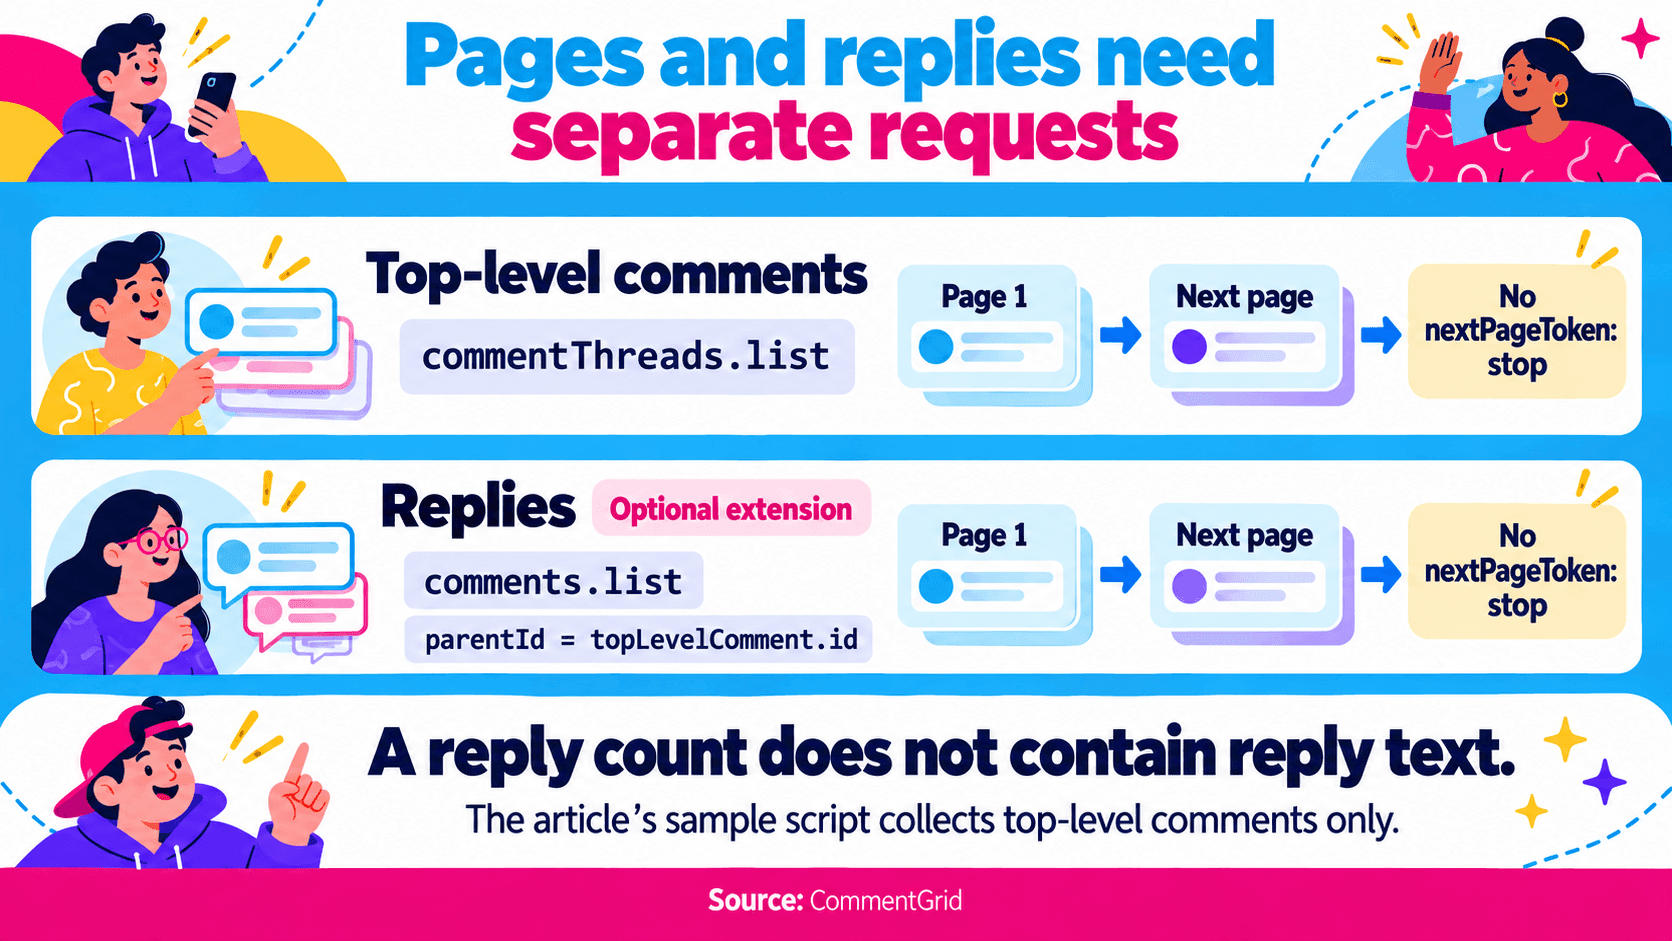 Un hilo y un comentario son registros diferentes. La documentación del recurso de hilos de comentarios de YouTube indica que las respuestas integradas en un hilo no necesariamente incluyen todas las respuestas.
Para ampliar el ejemplo y obtener respuestas:
- Identifica un comentario de nivel superior con un
totalReplyCountdistinto de cero. - Llama a
comments.listconpart=snippet,parentIdestablecido en ese ID de comentario de nivel superior ymaxResults=100. - Sigue el
nextPageTokende la respuesta de respuestas hasta que no haya más páginas. - Guarda el ID propio de cada respuesta y su
parentId, y marca el registro como una respuesta.
Usa topLevelComment.id para el padre, en lugar de asumir que el ID del hilo externo es intercambiable. Si también solicitas respuestas integradas, elimina los duplicados frente a los registros obtenidos por separado usando los ID de comentario.
Por ejemplo, un conjunto de datos con 80 comentarios de nivel superior y 40 respuestas recuperadas contiene 120 registros de comentarios. Un archivo con 80 filas y valores de recuento de respuestas que suman 40 todavía contiene solo 80 textos de comentarios.
5. Planifica la cuota y los errores
El calculador de cuota de Google actualmente indica tanto commentThreads.list como comments.list a una unidad de cuota por solicitud. Las páginas adicionales y las solicitudes de respuestas añaden llamadas cada una.
A efectos de planificación, 1,000 comentarios de nivel superior requerirían al menos 10 solicitudes si cada página devolviera 100 hilos. Recuperar respuestas añade solicitudes para los padres correspondientes. Las solicitudes fallidas también pueden consumir cuota, así que evita reintentar indefinidamente.
Usa la referencia de errores de la API para distinguir un problema de solicitud de un límite de acceso o de cuota:
| Error o síntoma | Qué comprobar |
|---|---|
commentsDisabled | El video tiene los comentarios desactivados; repetir la misma solicitud no los habilitará |
videoNotFound | Confirma el ID del video y si el video está disponible para la solicitud |
forbidden | Comprueba los requisitos de acceso y la autorización |
| Error relacionado con la cuota | Inspecciona la cuota del proyecto y el uso de solicitudes antes de reintentar |
| Solo se devuelve el primer lote | Comprueba si la respuesta contiene un token de página siguiente sin procesar |
Para un trabajo recurrente, registra qué video y qué página fallaron, mantén las credenciales fuera de los registros y anota si la recopilación terminó. Un conjunto de datos parcial debe poder identificarse como parcial.
¿Deberías usar un paquete de scraping de Python en su lugar?
Algunos proyectos de Python recopilan comentarios de las respuestas web de YouTube sin requerir que el usuario proporcione una clave de la API de datos. Eso puede reducir la configuración inicial de la API, pero introduce una dependencia del método de recopilación y del mantenimiento del proyecto.
Revisa el repositorio antes de adoptar un script de un tutorial antiguo. Por ejemplo, el repositorio del scraper de comentarios de YouTube de Bellingcat se archivó el 21 de enero de 2025. Esa es una razón para inspeccionar sus dependencias y alternativas antes de construir un nuevo flujo de trabajo en torno a él; no es prueba de que todos los comandos que contiene hayan dejado de funcionar.
Tanto para un paquete como para tu propio script, busca un manejo claro de la paginación, las respuestas, los ID duplicados y las solicitudes fallidas. Revisa los términos de la plataforma y las políticas de la API aplicables al método de recopilación que elijas. La ausencia de un requisito de clave de API no establece un acceso ilimitado o sin restricciones.
Cómo comprobar un conjunto de datos de comentarios de YouTube extraídos
Usa las mismas comprobaciones tanto si tu archivo proviene de una herramienta sin código como de Python.
| Comprobación | Qué registrar o inspeccionar |
|---|---|
| Origen | URL o ID del video, además de las horas de inicio y fin de la recopilación |
| Alcance | Solo comentarios de nivel superior, o comentarios de nivel superior y respuestas recuperadas |
| Finalización | Si finalizó cada página solicitada, se alcanzó un límite o un error detuvo la ejecución |
| Identidad | ID de comentario para los registros; ID de canal del autor cuando sea necesario y esté disponible |
| Contexto | Relaciones con el comentario padre y enlaces de vuelta al origen cuando estén disponibles |
Estas son comprobaciones para aplicar a tu conjunto de datos, no una garantía de que todas las herramientas creen automáticamente todos estos campos.
Inspecciona algunos comentarios comparándolos con el video y abre al menos un hilo con respuestas. Si estás midiendo preguntas o sentimiento, confirma que una respuesta corta todavía tiene sentido junto a su comentario padre.
No elimines duplicados por autor a menos que quieras específicamente una fila por participante. Una persona puede escribir varios comentarios diferentes. Para recopilaciones repetidas, conserva la hora de recopilación junto a (video_id, comment_id) para que los cambios en los me gusta o en el texto sigan siendo distinguibles de los registros duplicados.
Una vez que confíes en el alcance del archivo, usa nuestra guía de búsqueda de comentarios de YouTube para encontrar palabras clave o autores en los datos exportados. Para las entradas de concursos, sigue la guía aparte para elegir un ganador entre los comentarios de YouTube, donde las reglas del concurso determinan cómo deben contar los comentaristas repetidos.
Preguntas frecuentes
¿Puedo extraer comentarios de YouTube sin una clave de API?
Sí. La herramienta web de CommentGrid no requiere que proporciones una clave de API de YouTube. El ejemplo de la API de Python en esta guía requiere tu propia clave. Otros paquetes tienen su propia configuración y requisitos de acceso.
¿Puede un extractor de comentarios de YouTube recuperar todos los comentarios?
No asumas que puede. Comprueba la paginación, la recopilación de respuestas, los límites de procesamiento y los fallos. Los comentarios eliminados, moderados o inaccesibles pueden estar ausentes, y la conversación puede cambiar durante la recopilación. Describe el resultado usando su alcance y momento reales de recopilación.
¿Un recuento de respuestas significa que las respuestas se extrajeron?
No. Un recuento describe el hilo; no contiene el texto de las respuestas. Con la API oficial, usa solicitudes paginadas de respuestas por separado cuando necesites esos registros. El script de ejemplo anterior no realiza esas solicitudes.
¿El ejemplo de Python recopila el chat en vivo de YouTube?
No. Solicita hilos de comentarios de videos. Los mensajes de chat en vivo usan recursos de API separados y necesitan un flujo de trabajo de recopilación diferente.
¿Python es mejor que una herramienta sin código?
Usa Python cuando controlar las solicitudes, los esquemas y las ejecuciones repetidas justifique la configuración y el mantenimiento. Usa una herramienta sin código cuando un conjunto de datos descargable y la revisión manual satisfagan la tarea. Ambas necesitan una comprobación de registros faltantes y cobertura de respuestas.
Exporta más comentarios de YouTube con CommentGrid
Obtén límites de exportación más altos con CommentGrid en Chrome de escritorio. Regístrate para recibir 300 créditos gratis.
Añade CommentGrid a Chrome¿Prefieres probarlo primero? Prueba la herramienta web gratuita de YouTube.
 M
Marshall Sun
Building CommentGrid to decode social conversations. Exploring the signal within the noise of the global social web.