10 min de lecture
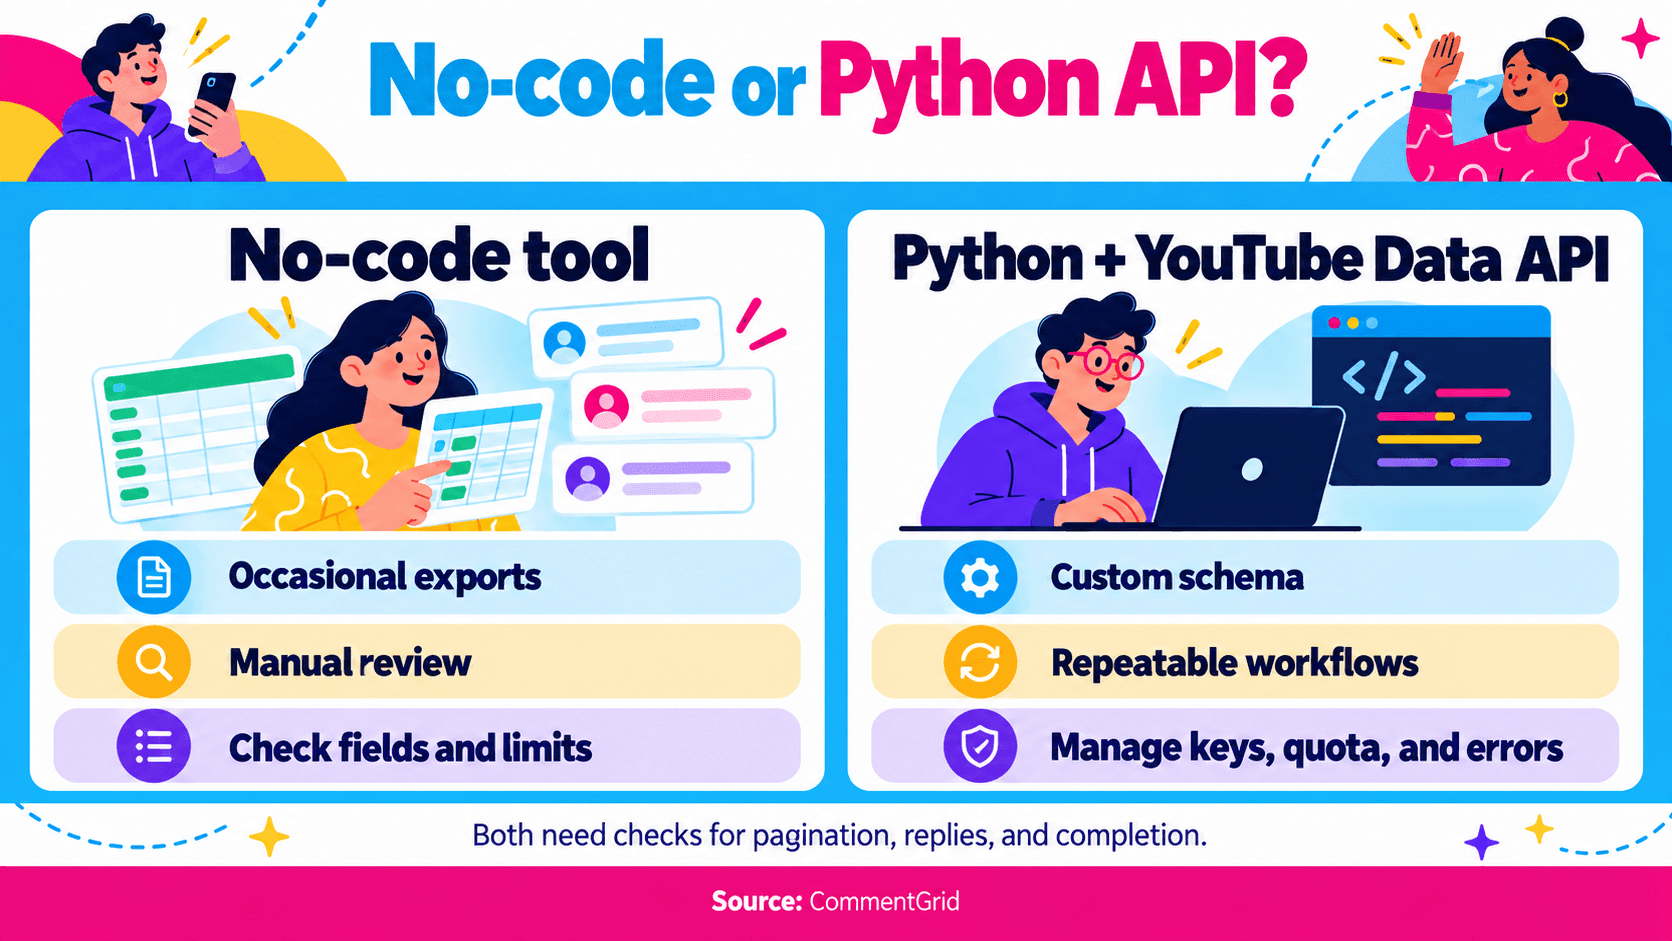
Un scraper de commentaires YouTube collecte les commentaires d’une vidéo dans des enregistrements que vous pouvez rechercher, analyser ou traiter par code. Pour un tableur occasionnel, un outil no-code constitue généralement le point de départ le plus rapide. Pour un workflow à personnaliser et à exécuter de façon répétée, Python avec l’API YouTube Data vous donne le contrôle sur les requêtes et la sortie.
Avant de choisir une méthode, vérifiez si elle collecte les réponses, parcourt chaque page de résultats et signale les requêtes ayant échoué. Ces détails déterminent ce que vous pouvez conclure à partir des données.
Ce guide compare les méthodes et inclut un exemple Python pour les commentaires de premier niveau. Si vous savez déjà que vous voulez un tableur, suivez notre tutoriel d’export de commentaires YouTube pour les étapes de téléchargement et Excel.
Quelle méthode d’extraction de commentaires YouTube choisir ?
| Méthode | Bon usage | Configuration | Points à vérifier |
|---|---|---|---|
| Outil web no-code | Un jeu de données ponctuel pour une revue manuelle | Une URL de vidéo prise en charge ; aucun code local | Champs renvoyés, couverture des réponses, limites actuelles et options de téléchargement |
| Python avec l’API officielle | Un workflow répétable avec votre propre schéma et votre traitement | Projet Google Cloud, API YouTube Data activée, clé API et Python | Pagination, requêtes séparées pour les réponses, quota et gestion des erreurs |
| Package Python qui lit les réponses web de YouTube | Un projet dont le mainteneur a évalué cette méthode de collecte | Dépendances propres au package et maintenance continue | Correctifs récents, comportement de collecte, exigences de plateforme et signalement des échecs |
Un créateur qui examine les questions sous une vidéo peut avoir besoin d’un fichier aujourd’hui. Un chercheur qui compare le même ensemble de vidéos chaque semaine peut avoir besoin de code, de journaux de collecte et d’un schéma cohérent.
Le terme « scraper » est souvent utilisé au sens large pour désigner les outils de collecte de commentaires. L’exemple Python ci-dessous utilise l’API documentée de YouTube plutôt que l’analyse de la page de visionnage.
Quand un scraper de commentaires YouTube no-code est pertinent
Utilisez un outil no-code lorsque la collecte des données ne représente qu’une petite partie d’une tâche plus vaste : lire des retours produit, trouver des questions du public ou préparer un rapport de campagne.
L’exportateur de commentaires YouTube CommentGrid vous permet d’exporter jusqu’à 10 commentaires par vidéo gratuitement, avec des téléchargements CSV et JSON. Vous pouvez essayer l’outil web sans configurer de clé API YouTube ni installer d’extension. Pour des exports plus volumineux, utilisez l’extension Chrome CommentGrid sur un ordinateur de bureau.
Avant de vous lancer dans une collecte importante, vérifiez un petit résultat :
- Contient-il le texte, les informations sur l’auteur, les horodatages et les champs d’engagement dont vous avez besoin ?
- Les textes des réponses sont-ils présents, ou le tableau affiche-t-il seulement un nombre de réponses ?
- L’outil signale-t-il une limite ou une exécution incomplète ?
Un workflow no-code nécessite tout de même que quelqu’un examine la sortie. Vérifiez les limites actuelles de l’outil et de votre offre plutôt que de supposer qu’un seul outil peut récupérer chaque commentaire de chaque vidéo.
Sur ordinateur, copiez l’adresse de la vidéo concernée ou utilisez Partager → Copier. Dans l’application YouTube sur iPhone ou Android, utilisez Partager → Copier le lien. Notre guide des liens de publications et de vidéos couvre les deux méthodes.
Comment extraire les commentaires YouTube avec Python
Python est utile lorsque vous devez choisir les champs, conserver les identifiants de source ou alimenter un autre processus avec les résultats. Pour cet exemple, utilisez l’API officielle YouTube Data afin que les paramètres de requête et la structure de réponse soient documentés.
1. Préparez votre accès à l’API
Suivez le guide de démarrage de l’API YouTube Data de Google pour créer un projet, activer l’API et obtenir une clé API. Gardez la clé hors des scripts et notebooks partagés, et limitez-la à l’usage prévu.
L’exemple demande les fils de commentaires publics d’une vidéo. Il n’implémente pas OAuth pour les opérations de gestion de chaîne ni l’accès aux données de modération non publiques.
Vous avez besoin de Python 3, mais d’aucun paquet Python supplémentaire. Enregistrez le code ci-dessous sous youtube_comment_scraper.py.
import json
import os
import re
import sys
from datetime import datetime, timezone
from getpass import getpass
from pathlib import Path
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import urlopen


def collect_top_level(video_id, api_key):
    records, page_token = {}, None
    while True:
        params = {
            "part": "snippet", "videoId": video_id,
            "maxResults": 100, "order": "time",
            "textFormat": "plainText", "key": api_key,
        }
        if page_token:
            params["pageToken"] = page_token
        url = "https://www.googleapis.com/youtube/v3/commentThreads?"
        with urlopen(url + urlencode(params), timeout=30) as response:
            page = json.load(response)
        for thread in page.get("items", []):
            comment = thread["snippet"]["topLevelComment"]
            snippet = comment["snippet"]
            records[comment["id"]] = {
                "comment_id": comment["id"],
                "text": snippet.get("textDisplay", ""),
                "author_name": snippet.get("authorDisplayName", ""),
                "author_channel_id": (snippet.get("authorChannelId") or {}).get("value", ""),
                "published_at": snippet.get("publishedAt", ""),
                "like_count": snippet.get("likeCount", 0),
                "reply_count": thread["snippet"].get("totalReplyCount", 0),
            }
        page_token = page.get("nextPageToken")
        if not page_token:
            return list(records.values())


def main():
    if len(sys.argv) != 2 or not re.fullmatch(r"[A-Za-z0-9_-]{11}", sys.argv[1]):
        raise SystemExit("Usage: python3 youtube_comment_scraper.py VIDEO_ID (11 characters)")
    video_id = sys.argv[1]
    api_key = os.environ.get("YOUTUBE_API_KEY") or getpass("YouTube API key: ")
    if not api_key.strip():
        raise SystemExit("An API key is required.")
    started_at = datetime.now(timezone.utc)
    try:
        comments = collect_top_level(video_id, api_key.strip())
    except HTTPError as error:
        try:
            reason = json.load(error)["error"]["errors"][0]["reason"]
        except (ValueError, KeyError, IndexError, TypeError):
            reason = "requestFailed"
        raise SystemExit(f"YouTube API error {error.code}: {reason}") from None
    except (URLError, TimeoutError):
        raise SystemExit("Network request failed; no new output file was written.") from None
    result = {
        "video_id": video_id,
        "collection_started_at_utc": started_at.isoformat(),
        "collection_finished_at_utc": datetime.now(timezone.utc).isoformat(),
        "scope": "top_level_comments_only",
        "comment_count": len(comments), "comments": comments,
    }
    stamp = started_at.strftime("%Y%m%dT%H%M%S%fZ")
    output = Path(f"youtube_{video_id}_{stamp}_top_level.json")
    with output.open("x", encoding="utf-8") as handle:
        json.dump(result, handle, ensure_ascii=False, indent=2)
    print(f"Saved {len(comments)} top-level comments to {output}")


if __name__ == "__main__":
    main()
Exécutez-le dans un terminal en remplaçant VIDEO_ID par l’ID à 11 caractères présent dans l’URL de la vidéo :
python3 youtube_comment_scraper.py VIDEO_ID
Pour une URL de visionnage standard, l’ID est la valeur située après v= et avant tout paramètre & suivant. Le script demande votre clé API sans l’afficher. Il accepte aussi une variable d’environnement YOUTUBE_API_KEY si vous fournissez déjà vos identifiants de cette manière.
Chaque exécution réussie écrit un nouveau fichier nommé avec l’ID de la vidéo et un horodatage UTC. La valeur scope de la sortie l’identifie comme contenant uniquement des commentaires de premier niveau. Si une requête API échoue, le script s’arrête avant de créer un fichier de sortie ; corrigez la cause et relancez-le.
Ceci est un point de départ pour une seule vidéo. Il conserve les enregistrements en mémoire et n’ajoute ni nouvelles tentatives automatiques, ni points de contrôle, ni planification. Ajoutez-les délibérément avant de l’utiliser pour de gros travaux récurrents.
3. Comprenez la pagination avant de faire confiance au décompte
La méthode commentThreads.list renvoie une page de fils. Définir maxResults sur 100 demande jusqu’à 100 fils pour cette page. Cela ne demande pas chaque commentaire en un seul appel.
Lorsque la réponse inclut nextPageToken, envoyez cette valeur comme pageToken dans la requête suivante. La boucle s’arrête lorsqu’il n’y a plus de jeton suivant. Le guide de pagination de Google explique ce modèle.
L’exemple utilise order="time" et textFormat="plainText". Il n’applique pas de filtre par mot-clé, qui réduirait le jeu de données. Les commentaires peuvent changer pendant l’exécution de la pagination ; atteindre la dernière page ne produit donc pas pour autant une archive permanente de la discussion.
4. Collectez les réponses séparément lorsque vous en avez besoin
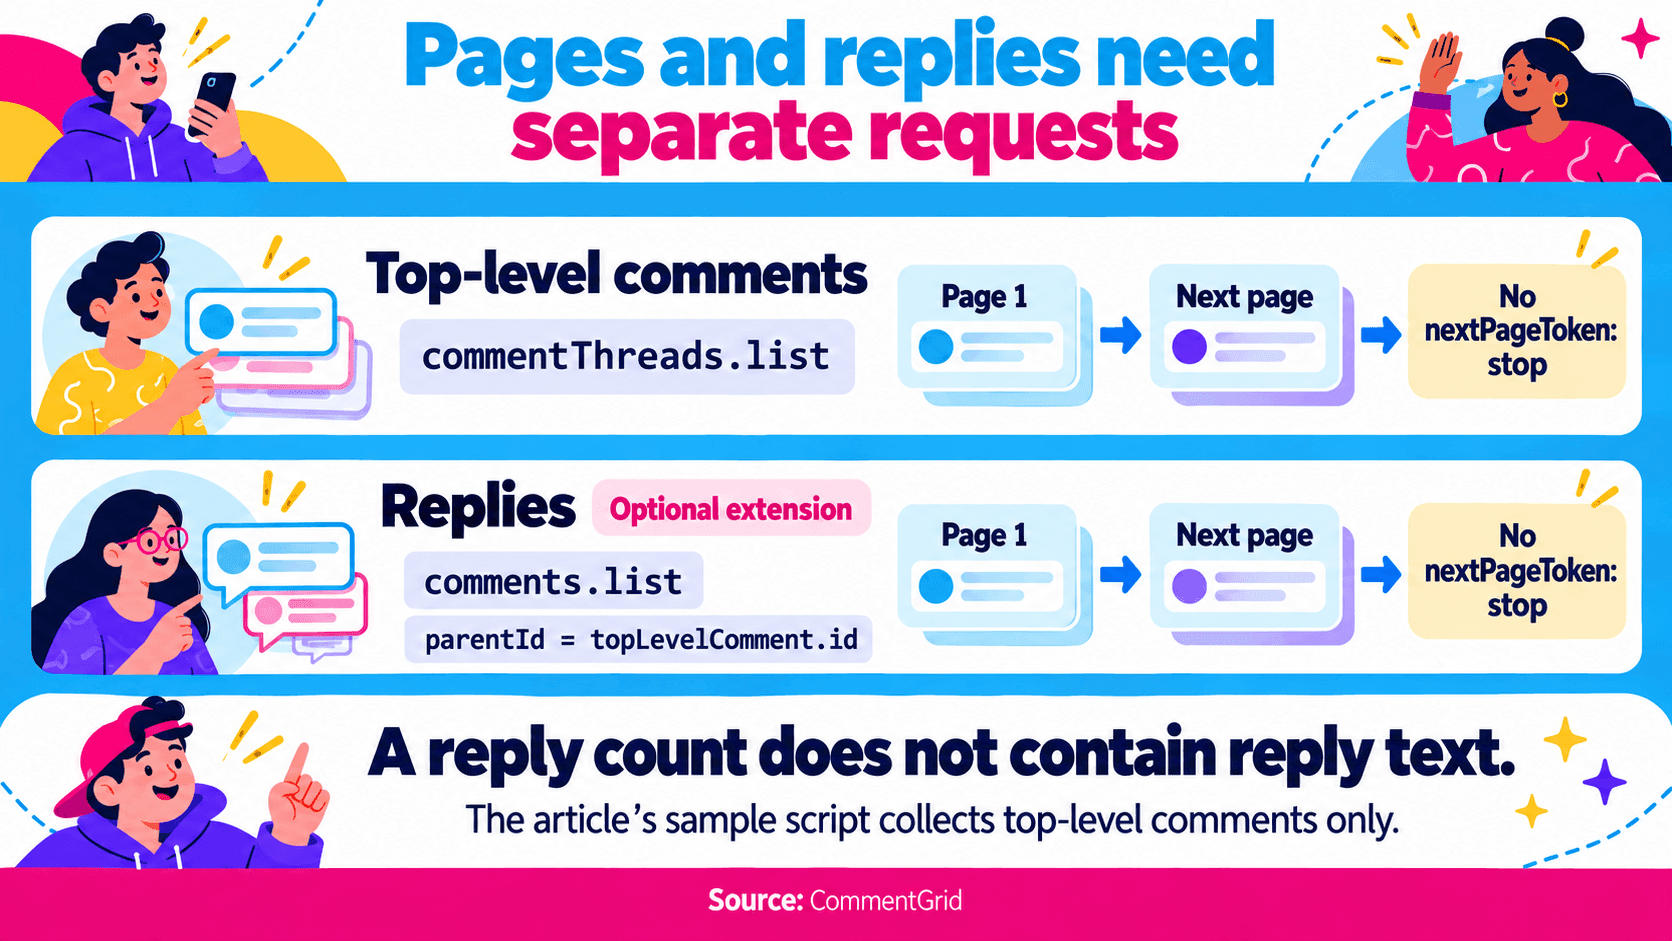 Un fil et un commentaire sont des enregistrements différents. La documentation de la ressource fil de commentaires de YouTube indique que les réponses intégrées à un fil n’incluent pas nécessairement toutes les réponses.
Pour étendre l’exemple aux réponses :
- Identifiez un commentaire de premier niveau dont le
totalReplyCountest différent de zéro. - Appelez
comments.listavecpart=snippet,parentIddéfini sur cet ID de commentaire de premier niveau, etmaxResults=100. - Suivez le
nextPageTokenrenvoyé pour les réponses jusqu’à ce qu’il n’y ait plus de pages. - Stockez l’ID propre à chaque réponse et son
parentId, et marquez l’enregistrement comme une réponse.
Utilisez topLevelComment.id pour le parent, plutôt que de supposer que l’ID du fil externe est interchangeable. Si vous demandez aussi les réponses intégrées, dédupliquez-les par rapport aux enregistrements récupérés séparément en utilisant les ID de commentaire.
Par exemple, un jeu de données avec 80 commentaires de premier niveau et 40 réponses récupérées contient 120 enregistrements de commentaires. Un fichier avec 80 lignes et des valeurs de nombre de réponses totalisant 40 ne contient toujours que 80 textes de commentaires.
5. Prévoyez le quota et les erreurs
Le calculateur de quota de Google indique actuellement commentThreads.list et comments.list à une unité de quota par requête. Les pages supplémentaires et les requêtes de réponses ajoutent chacune des appels.
À des fins de planification, 1 000 commentaires de premier niveau nécessiteraient au moins 10 requêtes si chaque page renvoyait 100 fils. La récupération des réponses ajoute des requêtes pour les parents concernés. Les requêtes ayant échoué peuvent aussi consommer du quota ; évitez donc de réessayer indéfiniment.
Utilisez la référence des erreurs de l’API pour distinguer un problème de requête d’une limite d’accès ou de quota :
| Erreur ou symptôme | Ce qu’il faut vérifier |
|---|---|
commentsDisabled | Les commentaires de la vidéo sont désactivés ; répéter la même requête ne les activera pas |
videoNotFound | Confirmez l’ID de la vidéo et si la vidéo est disponible pour la requête |
forbidden | Vérifiez les exigences d’accès et l’autorisation |
| Erreur liée au quota | Inspectez le quota du projet et l’utilisation des requêtes avant de réessayer |
| Seul le premier lot est renvoyé | Vérifiez si la réponse contient un jeton de page suivante non traité |
Pour une tâche récurrente, journalisez la vidéo et la page qui ont échoué, gardez les identifiants hors des journaux et consignez si la collecte s’est terminée. Un jeu de données partiel doit pouvoir être identifié comme partiel.
Faut-il plutôt utiliser un package Python de scraping ?
Certains projets Python collectent les commentaires à partir des réponses web de YouTube sans exiger de l’utilisateur qu’il fournisse une clé API Data. Cela peut réduire la configuration initiale de l’API, mais introduit une dépendance à la méthode de collecte et à la maintenance du projet.
Vérifiez le dépôt avant d’adopter un script issu d’un ancien tutoriel. Par exemple, le dépôt du scraper de commentaires YouTube de Bellingcat a été archivé le 21 janvier 2025. C’est une raison d’inspecter ses dépendances et ses alternatives avant de construire un nouveau workflow autour de lui ; ce n’est pas la preuve que chaque commande qu’il contient a cessé de fonctionner.
Que vous utilisiez un package ou votre propre script, recherchez une gestion claire de la pagination, des réponses, des ID en double et des requêtes ayant échoué. Vérifiez les conditions de la plateforme et les politiques API applicables à la méthode de collecte choisie. L’absence d’exigence de clé API ne signifie pas un accès illimité ou sans restriction.
Comment vérifier un jeu de données de commentaires YouTube extrait
Appliquez les mêmes vérifications que votre fichier provienne d’un outil no-code ou de Python.
| Vérification | Ce qu’il faut consigner ou inspecter |
|---|---|
| Source | URL ou ID de la vidéo, ainsi que les heures de début et de fin de la collecte |
| Périmètre | Commentaires de premier niveau uniquement, ou commentaires de premier niveau et réponses récupérées |
| Achèvement | Si chaque page demandée a été terminée, si une limite a été atteinte ou si une erreur a arrêté l’exécution |
| Identité | ID de commentaire pour les enregistrements ; ID de chaîne de l’auteur lorsque nécessaire et disponible |
| Contexte | Relations avec les commentaires parents et liens vers la source lorsqu’ils sont disponibles |
Il s’agit de vérifications à appliquer à votre jeu de données, et non d’une garantie que chaque outil crée automatiquement tous ces champs.
Inspectez quelques commentaires par rapport à la vidéo et ouvrez au moins un fil avec des réponses. Si vous mesurez des questions ou le sentiment, confirmez qu’une réponse courte garde son sens aux côtés de son commentaire parent.
Ne dédupliquez pas par auteur, sauf si vous voulez spécifiquement une ligne par participant. Une personne peut écrire plusieurs commentaires différents. Pour les collectes répétées, conservez l’heure de collecte à côté de (video_id, comment_id) afin que les changements de likes ou de texte restent distinguables des enregistrements en double.
Une fois que vous faites confiance au périmètre du fichier, utilisez notre guide de recherche des commentaires YouTube pour trouver des mots-clés ou des auteurs dans les données exportées. Pour les participations à un concours, suivez le guide distinct pour choisir un gagnant parmi les commentaires YouTube, où les règles de participation déterminent comment les commentateurs répétés doivent être comptés.
Questions fréquentes
Puis-je extraire des commentaires YouTube sans clé API ?
Oui. L’outil web de CommentGrid ne vous oblige pas à fournir une clé API YouTube. L’exemple Python avec l’API dans ce guide nécessite votre propre clé. Les autres packages ont leur propre configuration et leurs propres exigences d’accès.
Un scraper de commentaires YouTube peut-il récupérer chaque commentaire ?
Ne partez pas du principe qu’il le peut. Vérifiez la pagination, la collecte des réponses, les limites de traitement et les échecs. Les commentaires supprimés, modérés ou inaccessibles peuvent être absents, et la discussion peut changer pendant la collecte. Décrivez le résultat en fonction de son périmètre et de son heure de collecte réels.
Un nombre de réponses signifie-t-il que les réponses ont été extraites ?
Non. Un nombre décrit le fil ; il ne contient pas le texte des réponses. Avec l’API officielle, utilisez des requêtes paginées distinctes pour les réponses lorsque vous avez besoin de ces enregistrements. Le script d’exemple ci-dessus n’effectue pas ces requêtes.
L’exemple Python collecte-t-il le chat en direct de YouTube ?
Non. Il demande les fils de commentaires de la vidéo. Les messages du chat en direct utilisent des ressources API distinctes et nécessitent un workflow de collecte différent.
Python est-il meilleur qu’un outil no-code ?
Utilisez Python lorsque le contrôle des requêtes, des schémas et des exécutions répétées justifie la configuration et la maintenance. Utilisez un outil no-code lorsqu’un jeu de données téléchargeable et une revue manuelle suffisent à la tâche. Les deux nécessitent une vérification des enregistrements manquants et de la couverture des réponses.
Exportez plus de commentaires YouTube avec CommentGrid
Obtenez des limites d’export plus élevées avec CommentGrid dans Chrome sur ordinateur. Inscrivez-vous pour recevoir 300 crédits gratuits.
Ajouter CommentGrid à ChromeVous préférez d’abord essayer ? Essayez l’outil web YouTube gratuit.
 M
Marshall Sun
Building CommentGrid to decode social conversations. Exploring the signal within the noise of the global social web.